AI 一次能讀多少:長文件、上下文與分段處理
把一份上百頁的合約、一整年的會議紀錄或一整套產品手冊丟給 AI,請它整理重點,現在已經做得到。但很多人也遇過這種情況:文件很長時,AI 的摘要漏掉了關鍵的一段,或回答時把不同章節的內容混在一起。這和 AI 一次能「看見」多少內容,以及它怎麼處理這些內容有關。
上下文:AI 的工作記憶
每個模型都有一個能同時處理的內容上限,一般稱為上下文長度,可以想成它的工作記憶。你給的文件、你的問題、它的回答,都要放進這個空間。近年模型的上下文越來越大,很多已經能一次讀進相當長的文件,但「讀得進去」不等於「每一處都同樣仔細」。研究與實務經驗都發現,內容很長時,夾在中間的資訊比較容易被忽略。
另外,上下文越長,處理的費用與等待時間通常也越高。把整份文件每次都完整丟進去,未必是最划算的做法。
另一個要注意的是格式。掃描成圖片的文件、複雜的表格、多欄排版,在轉成 AI 讀得懂的文字時可能失真,例如表格欄位錯位、頁首頁尾混進內文。重要文件處理前,先確認轉換後的內容是否正確。
處理長文件的實用做法
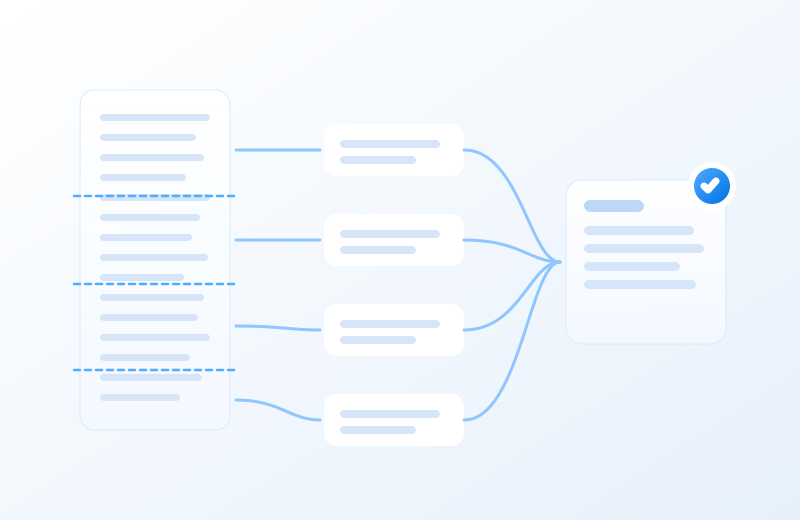
- 先分段再彙整:把文件依章節切開,各自摘要後再整合,比一次處理整份更不容易漏掉細節。
- 問題要具體:與其請它「整理重點」,不如問「付款條件與違約責任寫了什麼」,讓它聚焦在你關心的段落。
- 要求標出處:請 AI 註明每個重點出自第幾頁或哪一節,方便回頭核對原文。
- 只給需要的部分:經常查詢的文件,可以先建立索引,每次只把相關段落交給 AI,而不是整份重讀。
AI 讀得下長文件,不代表每一頁都讀得一樣仔細;切段、聚焦、標出處,結果會可靠得多。
這對你的生意意味著什麼
企業裡有大量長篇文件:合約、規章、技術手冊、會議紀錄、標案資料。AI 能大幅縮短閱讀與整理的時間,但前提是用對方法。了解上下文的限制,設計分段與查核的流程,才能把「讀得快」變成「讀得準」。經常要查的文件,例如公司規章與產品手冊,建立一次索引就能反覆使用,比每次重新上傳更有效率。
對於重要的文件,例如合約與法規,AI 的整理仍應作為參考,關鍵條文由人確認原文。創智苑協助企業導入 AI 時,會依文件的長度與用途,設計分段、索引與出處標註的處理方式。
— WITHTRON 創智苑