讀得到,才談得上讀得懂:AI 進不了你的官網時會發生什麼
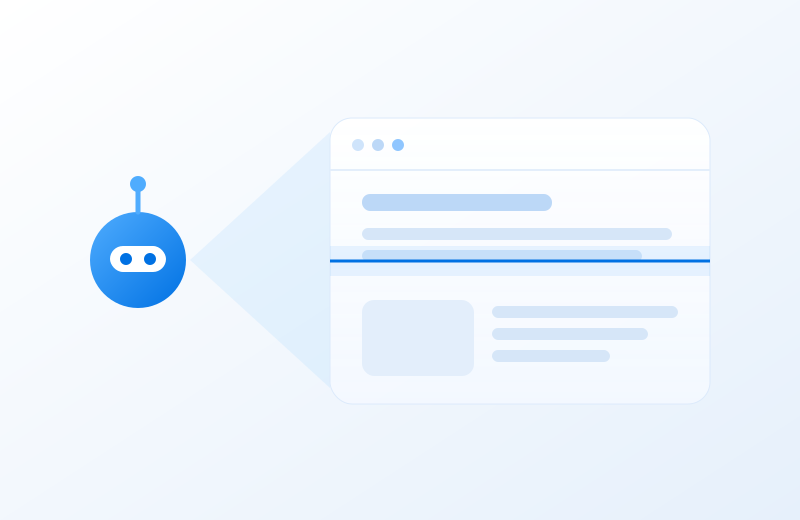
談到讓 AI 推薦自己的公司,大家很自然會先想到內容要怎麼寫、關鍵字要怎麼放。但在那之前,有一個更基本的前提常被略過:AI 的程式到底讀不讀得到你的網站。內容寫得再好,機器進不了門,或進了門只看到一片空白,後面的努力都派不上用場。
機器看網站的方式,和人不一樣
人打開網站,看到的是瀏覽器把文字、圖片、樣式組合好的畫面。搜尋引擎和 AI 服務派出的爬蟲程式,則是去抓網頁的原始內容。如果網站的主要文字要靠瀏覽器執行程式之後才「長出來」,有些爬蟲抓到的只是一個空殼,看不到任何實際介紹。Google 的爬蟲可以執行一部分網頁程式,但不是每一個 AI 服務的爬蟲都會這麼做,也不保證每次都完整。
值得一提的是,AI 回答問題時取得資料的管道不只一種:有些依賴自己的爬蟲,有些會借助搜尋引擎的結果。也就是說,對傳統搜尋引擎友善的網站,在 AI 的世界裡同樣佔有優勢,兩件事並不衝突。網站地圖也有幫助,它像一份目錄,告訴爬蟲網站上有哪些頁面、哪些最近更新過。
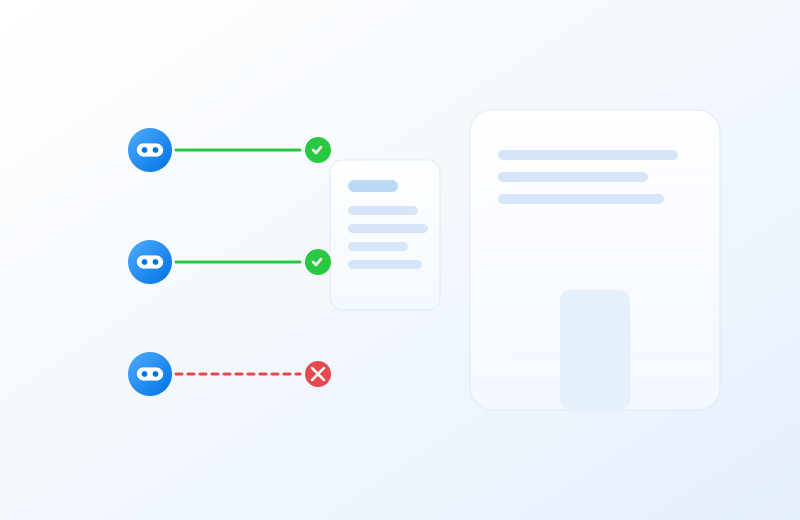
另一個常見狀況,是網站自己把門關上了。為了擋惡意流量,主機或防火牆的設定有時會一併擋下正常的爬蟲;網站根目錄的 robots.txt 檔,也可能在多年前被設成拒絕某些程式進入,之後再也沒人檢查過。
幾個值得先確認的地方
這些事不需要老闆自己動手,但可以請負責網站的人回答:
- 關掉瀏覽器的程式執行功能,主要內容還在不在:公司介紹、服務項目、聯絡方式如果都消失,代表內容高度依賴前端程式。
- robots.txt 有沒有擋到不該擋的對象:要不要讓 AI 爬蟲讀取,是公司可以決定的事,但應該是有意識的決定,而不是舊設定的副作用。
- 防護設定有沒有誤傷:擋攻擊很重要,但規則太寬時,正常的搜尋引擎與爬蟲也可能被拒於門外。
- 網站速度與穩定度:頁面經常逾時或出錯,爬蟲來幾次都拿不到內容,自然也就不會被收錄。
被 AI 理解之前,得先被 AI 讀到;這一步沒做到,內容寫得再好也沒人看見。
這對你的生意意味著什麼
「讀得到」聽起來很技術,影響的卻是你在 AI 回答裡有沒有出現的機會。一個在伺服器端就把完整文字準備好的網站,對人、對搜尋引擎、對 AI 都一樣清楚;反過來,一個只對瀏覽器友善的網站,等於在新的入口前把自己藏了起來。好消息是,這類問題多半在網站架構層就能解決,而且解決一次就長期受益。網站改版時尤其要留意:新版畫面更漂亮,卻改用大量前端程式產生內容,是很常見的退步。
如果你不確定自家官網在機器眼中長什麼樣子,可以先從上面幾點問起。創智苑在建置網站時,會讓每一頁在伺服器端就輸出完整內容,把「讀得到」當成基本規格,而不是事後補救。